本系列回答一个问题:Nginx 为什么能用极少的资源扛住海量流量,以及在生产环境中如何用好它、查清它的故障。 版本基准:1.30.5 stable(生产推荐),1.31.x mainline 的新特性会单独标注。资料来源为 nginx.org 官方文档、CHANGES 和官方博客,截至 2026 年 9 月。
阅读路径 本系列采用「总—分」结构,共 9 篇,可以按顺序阅读,也可以按需跳读:
• **先读总览(00):**建立全局认知,包括定位、价值、竞品对比、总体架构图、关键概念和一次请求的完整流程。 • **再读原理(01~06):**逐个展开架构图中的关键组件,从进程、事件,到请求处理、代理、内存与缓存,再到协议栈。 • **最后读实践(07~08):**把原理落到配置、调优和线上排障。
Master / Worker、reload、热升级、Control API 运维、SRE(Site Reliability Engineering,站点可靠性工程) 模块、11 个阶段、location 匹配、过滤器链 upstream 内存池、缓冲链、 sendfile 、 proxy_cache
1.29~1.31 版本中值得关注的变化
upstream 默认 keepalive 32,proxy 默认使用 HTTP/1.1 升级后要检查两端的 keepalive 超时是否匹配 开源版支持 least_time ,新增 tunnel 模块 Control API、谓词 location、JSON 模块 可以通过 HTTP 管理 reload,按请求内容路由
00 总览:Nginx 的定位、价值与总体架构 一句话结论:Nginx 用「一个 Master 进程管理 + 多个单线程 Worker 进程事件驱动」的架构,以极低的内存和 CPU(Central Processing Unit,中央处理器)开销同时处理数十万连接;它是当今互联网流量入口的事实标准,但在动态配置、主动健康检查和可观测性方面需要借助外部能力补齐。 版本基准:本系列以 1.30.5 stable(稳定版) 为生产基准,1.31.x mainline(主线版) 的新特性会单独标注。Nginx 版本号中次版本号为偶数的是 stable、奇数的是 mainline。
一、定位:Nginx 是什么 Nginx(读作 engine x)由 Igor Sysoev 于 2004 年发布,初衷是解决 C10K 问题(Concurrent 10,000 connections,单机同时处理一万个连接)。它采用 2-clause BSD(Berkeley Software Distribution)许可证开源,2019 年起由 F5 公司维护。
今天的 Nginx 是一个多协议流量处理引擎,同一个二进制可以承担以下角色:
ngx_http_static_module 为 Java / Go / Python 应用做统一入口 ngx_http_proxy_module ngx_http_upstream_module proxy_cache 代理 MySQL、Redis、DNS(Domain Name System,域名系统)等 TCP / UDP 流量 ngx_stream_ ngx_http_ssl_module
其中 HTTP 是 HyperText Transfer Protocol(超文本传输协议),TCP 是 Transmission Control Protocol(传输控制协议),UDP 是 User Datagram Protocol(用户数据报协议),TLS 是 Transport Layer Security(传输层安全协议);HTTPS(HTTP Secure)即基于 TLS 加密的 HTTP。
二、价值:为什么是 Nginx Nginx 的核心价值可以归结为三点:快、稳、可扩展。
1. **快:**高并发、低资源。每个 Worker 进程是一个单线程的事件循环,使用 epoll / kqueue 等 I/O(Input/Output,输入/输出)多路复用机制,一个线程就能同时管理数万个连接,不需要「一个连接一个线程」。官方数据是:一万个空闲的 HTTP 长连接只占约 2.5 MB 内存。 • Master 只负责管理,不处理请求。Worker 崩溃后,Master 会立即拉起新的 Worker。 • 修改配置后执行 nginx -s reload ,新旧 Worker 会平滑交接,已有连接不会中断。 3. **可扩展:**模块化 + 声明式配置。所有功能都以模块的形式实现,包括核心的 HTTP 处理。常见需求只要写配置就能完成;复杂需求可以用 njs(NGINX JavaScript)脚本,或者自己开发 C 模块。 三、竞品对比:Nginx 的优势与短板
可选的多进程 / 多线程 MPM(Multi-Processing Module,多处理模块) 中:有运行时 API(Application Programming Interface,应用程序编程接口) 服务网格、xDS(x Discovery Service,发现服务协议族)全动态配置
Nginx 的优势:性能和资源效率处于第一梯队;功能覆盖面最广,从静态资源到四层代理一个产品就能搞定;生态最成熟,OpenResty、Kubernetes Ingress、各大 CDN(Content Delivery Network,内容分发网络)都以它为基础;配置和排障经验资料极其丰富。
Nginx 的短板:
• **动态性不足:**增删后端、修改路由都要 reload。1.31.5 引入的 Control API 让 reload 可以通过 HTTP 调用触发,并同步返回结果,但本质仍是 reload。 • **主动健康检查需付费:**开源版只有被动检查(请求失败后才摘除节点),主动探测( health_check )属于商业版。 • **可观测性弱:**开源版的 stub_status 只有 7 个全局指标,细粒度监控需要借助日志分析或第三方模块。 • Worker 内不能有阻塞 :任何阻塞调用都会卡住整个 Worker 上的所有连接,这是事件驱动模型固有的约束。 ✅ **选型建议:**做通用的 Web 入口、静态资源服务、反向代理和缓存,Nginx 是默认首选;对全动态配置要求高的服务网格场景,优先考虑 Envoy;纯粹做四层 / 七层负载均衡、需要丰富健康检查时,可以考虑 HAProxy。
四、总体架构
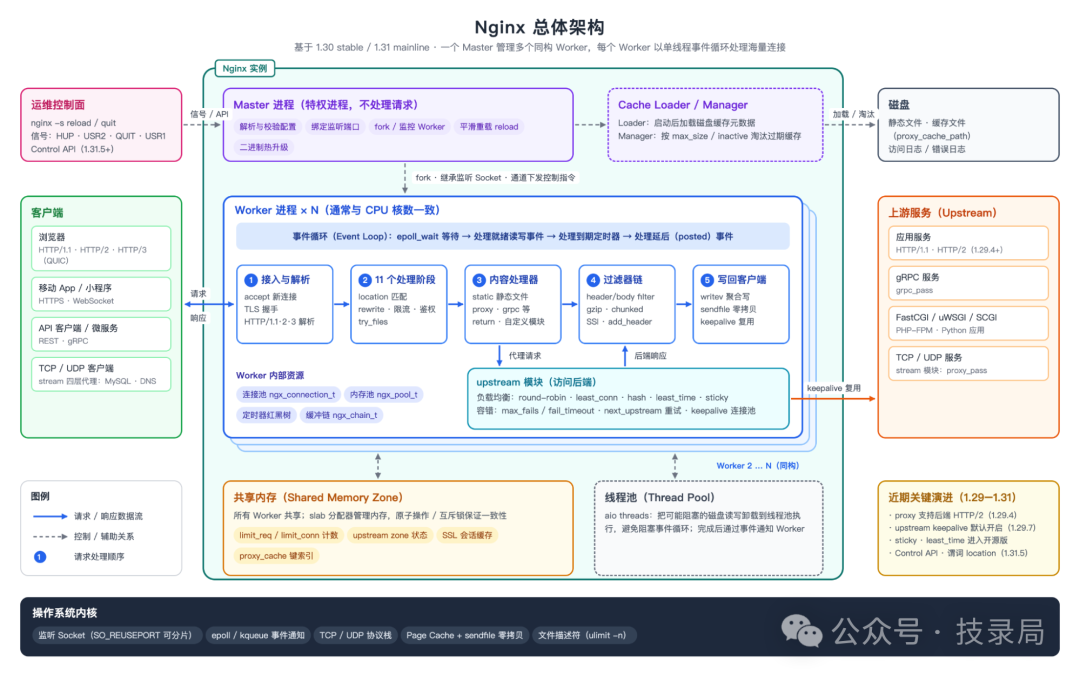
Nginx 总体架构图:Master 管理多个单线程 Worker 架构图从外到内分为四层:客户端和上游服务、Nginx 进程、进程间共享资源、操作系统内核。各组件的职责如下: 管理者:解析配置、绑定监听端口、创建和监控 Worker 通常以 root 运行,不处理任何请求;reload 和热升级都由它编排 数量一般等于 CPU 核数;彼此独立、互不通信;每个都是单线程事件循环 只有配置了 proxy_cache_path 才会启动 限流计数、SSL(Secure Sockets Layer,安全套接层,TLS 的前身)会话、缓存索引等必须放在这里,才能在多个 Worker 之间保持一致 用 aio threads 开启,防止大文件读取卡住事件循环 core、event、http、stream、mail 五大类,按需编译或动态加载
组件之间如何协同:
• Master 先创建监听 Socket,再 fork 出 Worker,Worker 继承这些 Socket,共同接收连接。 • Master 通过信号和进程间通道(channel)向 Worker 下发 reload、退出等指令。 • Worker 之间不直接通信,需要共享的状态都写在共享内存里,通过原子操作或互斥锁协调。 • Worker 内部,请求依次经过「接入解析 → 11 个处理阶段 → 内容处理器 → 过滤器链 → 写回」这条流水线。需要访问后端时,由 upstream 模块负责选择节点和复用连接。 五、关键概念 理解后续篇章,需要先建立以下概念:
Worker 从不等待 I/O:数据未就绪就先登记事件,转去处理别的连接,就绪后再回来继续 连接( ngx_connection_t )对应一个 TCP 连接;请求( ngx_http_request_t )对应一次 HTTP 交互;一个连接上可以有多个请求( keepalive 、HTTP/2 多路复用) main、events、http、server、location、 upstream 层层嵌套,内层继承外层配置 HTTP 请求处理被切成 11 个固定阶段,模块在各阶段注册回调 Handler 负责生成响应内容(每个 location 只能有一个);Filter 负责加工响应(可以串联多个) $host 、 $request_uri 等,按需求值(惰性计算),是配置表达能力的核心 按请求分配、整体释放的内存管理方式;用链表串联数据块,避免拷贝
六、总体流程:一次 HTTPS 请求的完整生命周期 启动阶段(只发生一次):Master 解析 nginx.conf → 初始化各模块、创建共享内存 → 绑定并监听端口 → fork 出 N 个 Worker → Worker 各自初始化事件循环,开始等待连接。
请求阶段(每个请求都会经过):
1. **建立连接:**内核完成 TCP 三次握手,把连接放进 accept 队列,通过 epoll 唤醒某个 Worker。Worker 调用 accept(),从连接池取出一个 ngx_connection_t 。 2. TLS 握手:根据 SNI(Server Name Indication,服务器名称指示)选择证书,完成握手;如果命中会话缓存,就走简化握手。 3. **解析请求:**读取请求行和请求头,创建 ngx_http_request_t ,按 Host 选中 server 块。 4. **阶段处理:**依次执行 11 个阶段:匹配 location、rewrite 重写、 limit_req 限流、allow / auth 鉴权等。 5. **生成内容:**location 中配置了 proxy_pass ,就由 proxy 模块接管:选择后端节点、复用 keepalive 连接、转发请求。 6. **加工响应:**后端响应依次流经 header filter 和 body filter,完成 gzip 压缩、添加响应头、chunked 编码等处理。 7. **写回客户端:**通过 writev / sendfile 发送数据,然后在 log 阶段写访问日志。 8. **连接复用:**连接进入 keepalive 状态等待下一个请求;超时后关闭,并把连接对象归还连接池。 💡 **关键理解:**以上每一步只要遇到「数据还没到」或「缓冲区写满了」,Worker 都会立即返回事件循环去处理其他连接,等事件就绪后再从断点继续。这就是 Nginx 单线程也能支撑海量并发的根本原因。
七、系列导读
Master / Worker 如何分工?reload 和热升级为什么不断流? 单线程如何管理数万连接?epoll 事件循环如何运转? 11 个阶段各做什么?location 如何匹配?模块如何协作? 请求如何转发到后端?负载均衡和失败重试的原理是什么? upstream 内存池、缓冲链、零拷贝、 proxy_cache 如何工作? TLS、HTTP/2、HTTP/3(基于 QUIC,即 Quick UDP Internet Connections 协议)在 Nginx 中如何实现?
01 进程模型:Master / Worker、平滑重载与热升级 核心结论:Nginx 把「管理」和「干活」拆给两类进程:Master 负责配置、监听端口和 Worker 的生命周期;Worker 负责处理所有请求。Worker 之间完全独立,因此不需要锁,还能天然利用多核;Master 始终在线,因此 reload、热升级和 Worker 崩溃都不会导致服务中断。
一、为什么选择「多进程 + 单线程」 常见的服务器并发模型有三种,Nginx 选择了第三种:
Apache worker、传统 Java BIO(Blocking I/O,阻塞式 I/O) 线程栈占内存;共享数据要加锁;一个线程出错可能拖垮整个进程 进程数固定(≈ CPU 核数),没有锁竞争,上下文切换极少
这个选择带来三个直接收益:
• **无锁:**每个 Worker 只处理自己接收的连接,绝大部分数据结构都是进程私有的,只有共享内存需要同步。 • **多核扩展:**Worker 数量等于 CPU 核数,还可以用 worker_cpu_affinity 把 Worker 绑定到固定的核上,减少缓存失效。 • **故障隔离:**某个 Worker 崩溃,只会影响它自己正在处理的连接,Master 会立即补上一个新的 Worker。 二、进程角色一览 在一台运行中的 Nginx 服务器上执行 ps,通常能看到以下进程:
root 1001 1 nginx: master process /usr/sbin/nginx -c /etc/nginx/nginx.conf
nginx 1002 1001 nginx: worker process
nginx 1003 1001 nginx: worker process
nginx 1004 1001 nginx: cache manager process
nginx 1005 1001 nginx: cache loader process
读取并校验配置;绑定 80 / 443 等特权端口;fork 并监控子进程;响应信号 worker_processes 启动后分批扫描缓存目录,把缓存元数据加载进共享内存,完成后退出 周期性检查缓存大小和过期时间,淘汰超出 max_size 或长期未访问(inactive)的缓存文件
💡 **安全设计:**只有 Master 以 root 身份运行,并且它不解析任何请求数据。处理外部输入的 Worker 以普通用户运行,即使 Worker 被攻破,攻击者也拿不到 root 权限。
三、启动流程:从 nginx 命令到开始服务 Nginx 启动时会创建一个核心结构 ngx_cycle_t ,它代表「一代配置」,包含配置树、监听 Socket 列表、共享内存列表、打开的文件等。之后的每次 reload,都会生成新的一代 cycle。
1. 解析配置: ngx_init_cycle () 读取 nginx.conf ,逐条执行指令对应的回调函数,生成各模块的配置结构体。 2. **创建共享内存:**为 limit_req_zone 、 proxy_cache_path 、 ssl_session_cache 等声明的 zone 分配共享内存。 3. 打开监听 Socket :对所有 listen 地址执行 socket()、bind()、listen()。 4. 进入 Master 循环 : ngx_master_process_cycle () 为每个 Worker 创建一对 socketpair 作为通信通道(channel),然后 fork。 5. Worker 初始化 :降权为普通用户、设置 CPU 亲和性、调用各模块的 init_process 回调,然后进入事件循环 ngx_process_events_and_timers (),开始接收连接。 由于监听 Socket 是在 fork 之前创建的,所有 Worker 继承的是同一组文件描述符,它们会共同竞争这些 Socket 上的新连接(具体如何分配见 02 篇)。
四、Master 如何控制 Worker Master 启动后,大部分时间阻塞在 sigsuspend() 上等待信号,收到信号后再执行对应的动作:
HUP QUIT 通知 Worker 处理完当前请求后退出,然后自己退出 TERM USR1 USR2 WINCH 只关闭 Worker,保留 Master,用于热升级 CHLD 如果 Worker 是异常退出,就立即重新 fork 一个
Master 向 Worker 下发指令有两条路径:一是通过 channel 发送 NGX_CMD_QUIT 、 NGX_CMD_TERMINATE 、 NGX_CMD_REOPEN 等命令;二是直接给 Worker 发信号。Worker 收到后只设置一个标志位,等回到事件循环的安全点再执行,避免在处理请求的中途被打断。
Control API:用 HTTP 管理 Master(1.31.5+,mainline) 信号机制有一个老问题: nginx -s reload 发出信号就立即返回,无法得知新配置到底有没有加载成功,只能事后去翻 error.log。1.31.5 把原来商业版独有的 Control API 开放到了开源版:
# 启动时开启 Control API,建议只监听本地 UNIX Socket
nginx -l unix:/run/nginx/control.sock

# 查看 Master 内存中实际生效的配置(含所有 include 文件)
curl --unix-socket /run/nginx/control.sock http://localhost/1/control/config

# 触发 reload,同步返回结果:成功返回 200,配置错误返回 422 和错误日志
curl --unix-socket /run/nginx/control.sock -X PATCH http://localhost/1/control/config
Control API 由 Master 进程直接提供,另外还有 /1/control/processes(查看 Worker 进程信息和退出状态)和 /1/nginx(查看版本和编译信息)两个端点。它特别适合容器和自动化发布平台:发布脚本可以直接根据 HTTP 状态码判断变更是否成功。
⚠️ 安全提示:Control API 能读取完整配置、触发 reload,务必只监听受限权限的 UNIX Socket,不要暴露在网络上。
五、平滑重载(reload):为什么不断流 执行 nginx -s reload 后,Master 按以下步骤完成「新旧交接」:
1. **校验与回滚:**Master 用新配置调用 ngx_init_cycle () 构建新一代 cycle。如果语法错误,或者端口、日志文件打不开,就直接丢弃新配置,继续用旧配置运行。 2. **复用资源:**监听地址没有变化的 Socket 直接沿用,不会关闭重开,所以不会出现端口的空窗期。名称和大小都没变的共享内存 zone 也会复用,限流计数、缓存索引不会丢失。 3. 启动新 Worker :用新配置 fork 出一批新的 Worker,立即开始接收新连接。 4. 优雅退出旧 Worker :通知旧 Worker 进入「shutting down」状态:关闭监听 Socket,不再接收新连接;关闭空闲的 keepalive 连接;把正在处理的请求处理完之后退出。 reload 期间,ps 里会同时出现新旧两批 Worker:
nginx: worker process is shutting down ← 旧 Worker,处理完存量请求后退出
nginx: worker process ← 新 Worker,已开始服务
⚠️ 常见问题:如果存在 WebSocket、gRPC 流、大文件下载这类长连接,旧 Worker 可能迟迟不退出。频繁 reload 会导致进程数和内存持续翻倍。可以用 worker_shutdown_timeout 30s; 限定优雅退出的最长时间,超时后强制关闭剩余连接。
六、二进制热升级:不停机更换版本 升级 Nginx 版本(或者加装静态编译的模块)需要更换可执行文件。热升级的核心思路是:新旧两代 Master 并存,共享同一组监听 Socket。
1. 用新二进制文件替换旧文件,然后向旧 Master 发送 USR2 。 2. 旧 Master 把 pid 文件重命名为 nginx.pid.oldbin ,然后 fork 并 exec 新的二进制文件。监听 Socket 的文件描述符通过环境变量 NGINX 传给新 Master,新 Master 直接继承使用,不需要重新 bind。 3. 新 Master 启动自己的 Worker 。此时新旧两批 Worker 同时接收请求。 4. 向旧 Master 发送 WINCH :旧 Worker 优雅退出,旧 Master 本身保留。 • **正常:**向旧 Master 发送 QUIT ,升级完成。 • **异常:**向旧 Master 发送 HUP ,它会重新拉起旧版本的 Worker;再向新 Master 发送 QUIT ,回滚完成。 💡 **适用范围:**在容器化部署中,通常直接滚动替换 Pod 或容器,很少使用二进制热升级;它主要用于物理机和虚拟机上长期运行的 Nginx 实例。
七、进程相关的关键配置 worker_processes auto; # Worker 数量,auto 表示等于 CPU 核数 worker_cpu_affinity auto; # 把 Worker 绑定到固定 CPU 核(Linux / FreeBSD) worker_rlimit_nofile 200000 ; # 每个 Worker 能打开的最大文件描述符数 worker_shutdown_timeout 30s ; # reload / quit 时旧 Worker 优雅退出的上限 events { worker_connections 65535 ; # 每个 Worker 的最大连接数(含到后端的连接) } ✅ 经验法则: worker_rlimit_nofile 要大于 worker_connections 。做反向代理时,每个客户端请求通常还要占用一个到后端的连接,所以一个 Worker 能同时服务的客户端数约为 worker_connections / 2。
02 事件驱动:epoll、事件循环与连接管理 核心结论:Worker 的全部工作都在一个循环里完成:「等待事件 → 处理就绪的读写事件 → 处理到期的定时器 → 再次等待」。所有 I/O 都是非阻塞的:数据没准备好就立即返回、登记事件,转去处理别的连接。因此一个线程就能同时推进数万个连接,前提是任何一步都不能阻塞。
一、从阻塞 I/O 到 I/O 多路复用 阻塞模型的问题:调用 read() 时如果数据还没到,线程就被挂起等待。要同时服务 1 万个连接,就需要 1 万个线程,内存和上下文切换的开销都会成为瓶颈。
I/O 多路复用的思路:把所有 Socket 都设置为非阻塞,然后交给内核统一监视,只处理已经就绪的那些。Linux 上先后出现过三种实现:
其中 fd 即 file descriptor(文件描述符)。Nginx 会自动选择平台上最高效的机制:Linux 用 epoll,FreeBSD / macOS 用 kqueue,Solaris 用 eventport。
二、epoll 的工作原理 epoll 只有三个系统调用:
• epoll_create ():在内核中创建一个 epoll 实例。它包含一棵红黑树(存放所有被监视的 fd)和一个就绪链表。 • epoll_ctl ():往红黑树里添加、修改或删除 fd,同时在该 fd 的等待队列上挂一个回调。 • epoll_wait ():如果就绪链表为空,就休眠等待;网卡收到数据、协议栈处理完成后,会触发回调,把对应的 fd 加入就绪链表,并唤醒等待者。 所以 epoll 的开销和「连接总数」无关,只和「就绪的连接数」有关,这正是它能支撑海量空闲长连接的原因。
触发模式:epoll 有两种通知方式:
• 水平触发(LT,Level Triggered):只要缓冲区里还有数据,每次 epoll_wait 都会报告。 • 边缘触发(ET,Edge Triggered):只在状态变化时(例如新数据到达)报告一次。 Nginx 对连接使用边缘触发。代价是每次都必须把数据读到返回 EAGAIN 为止,否则剩下的数据不会再被通知;好处是避免了重复通知带来的无效唤醒。
三、Nginx 的事件抽象 为了屏蔽不同平台的差异,Nginx 定义了统一的事件接口 ngx_event_actions (包含 add、del、 process_events 等操作),epoll、kqueue 等各自实现这组接口。上层代码只和三个核心结构打交道:
ngx_connection_t ngx_event_t handler(回调函数)、ready、active、timedout、timer ngx_cycle_t connections、 free_connections 、listening
关键设计:回调驱动的状态机。每个事件都绑定一个 handler。一个连接在处理的不同阶段,只需要替换 handler:例如等待请求头时,handler 是「解析请求头」;转发到后端后,handler 就换成「读取后端响应」。事件就绪时直接调用当前的 handler,处理逻辑从上次中断的地方继续。这样就用单线程实现了成千上万个「可暂停、可恢复」的执行流。
四、事件循环:Worker 的心跳 每个 Worker 都在无限循环调用 ngx_process_events_and_timers (),一轮循环大致如下:
for ( ;; ) {
    timer = ngx_event_find_timer(); // 1. 计算距离最近一个定时器到期还有多久
    if (accept_mutex) ngx_trylock_accept_mutex(); // 2. 可选:抢 accept 锁
    ngx_process_events(cycle, timer); // 3. epoll_wait(timeout = timer)
    ngx_time_update(); // 更新缓存的当前时间
    ngx_event_process_posted(accept_events); // 4. 先处理新连接事件
    ngx_shmtx_unlock(accept_mutex); // 尽快释放 accept 锁
    ngx_event_expire_timers(); // 5. 处理所有已到期的定时器
    ngx_event_process_posted(posted_events); // 6. 处理延后执行的普通读写事件
}
几个要点:
• 超时时间由最近的定时器决定: epoll_wait 最多只休眠到下一个定时器到期,保证超时能被及时处理。 • **时间缓存:**Nginx 在每轮循环里只获取一次系统时间,并缓存在 ngx_current_msec 中,避免频繁调用 gettimeofday()。可以用 timer_resolution 进一步降低更新频率。 • posted 队列:持有 accept 锁时,读写事件会先放进 posted 队列,等锁释放后再处理,这样可以缩短持锁时间。 五、定时器:超时如何实现 Nginx 的所有超时,包括 client_header_timeout 、 proxy_read_timeout 、 keepalive_timeout 等,都是基于同一棵红黑树实现的:
• 以「到期时间」为键,把事件插入红黑树( ngx_event_add_timer )。 • 每轮循环取出最左边(即最早到期)的节点,计算 epoll_wait 的超时时间。 • 到期后把事件的 timedout 置为 1 并调用它的 handler,由 handler 负责返回 408、504 等状态码,或者关闭连接。 💡 **理解超时语义:**Nginx 的大多数读写超时是指「两次连续读写操作之间」的间隔,而不是整个请求的总时长。比如 proxy_read_timeout 60s 表示后端连续 60 秒没有发送任何数据才判定超时;如果后端每 59 秒吐出一个字节,这个请求可以持续很久。
六、新连接如何分配给 Worker 所有 Worker 共享同一个监听 Socket。一个新连接到来时,内核唤醒哪个 Worker?Nginx 先后演进出以下几种方案:
所有 Worker 都监听同一个 Socket,被同时唤醒 惊群效应(Thundering Herd):只有一个 Worker 能 accept 成功,其余被白白唤醒 accept_mutex 各 Worker 竞争一把共享内存锁,只有持锁者注册监听事件 负载可能不均;有抢锁延迟。1.11.3 起默认关闭 Linux 4.5+ 的内核标志:每次只唤醒一个等待者 listen 80 reuseport;:每个 Worker 拥有独立的监听 Socket,由内核按四元组哈希分配连接 某个 Worker 卡顿时,分给它的连接会一起变慢
此外,Nginx 还有一个自我调节机制:当 Worker 的空闲连接数少于总数的 1/8 时,变量 ngx_accept_disabled 会变为正数,这个 Worker 会主动放弃若干轮 accept,把新连接让给更空闲的 Worker。
✅ **实践建议:**高并发的 Linux 场景下推荐开启 reuseport,同时确保 Worker 内没有阻塞操作。
七、连接池:worker_connections 的真实含义 每个 Worker 启动时,会一次性预分配 worker_connections 个 ngx_connection_t ,以及同样数量的读事件和写事件,用空闲链表管理:
• 新连接到来时,从 free_connections 链表头取出一个;连接关闭后放回链表。整个过程没有 malloc,是 O(1) 操作。 • **这个数量包括所有连接:**客户端连接、到后端的连接、到 DNS 解析器的连接,都会占用连接池中的位置。 • 连接池耗尽后,error.log 会出现 worker_connections are not enough,新连接将被拒绝。 最大并发连接数的估算:
worker_processes 约 worker_processes × worker_connections / 2(每个请求还要占用一个上游连接)
同时要满足 worker_rlimit_nofile ≥ worker_connections ,否则连接池还没用完,就会先遇到 Too many open files 错误。
八、非阻塞的边界:哪些操作会拖垮 Worker 事件驱动模型只有一个致命弱点:Worker 里任何一次阻塞,都会冻结它上面所有的连接。常见的阻塞来源和应对方式如下:
aio threads; 把磁盘读操作卸载到线程池;配合 directio 读取超大文件 只使用非阻塞 API(如 OpenResty 的 cosocket) gzip_comp_level 取 4~6;静态资源预压缩后用 gzip_static access_log
💡 **排查线索:**如果 $request_time 普遍偏高,而 $upstream_response_time 并不高,同时某个 Worker 的 CPU 持续 100%,基本可以判定是 Worker 内部出现了阻塞或者 CPU 密集型操作。具体方法见 08 篇。
03 请求处理:模块体系、11 个阶段与 location 匹配 核心结论:Nginx 把一次 HTTP 请求的处理拆成三段流水线:11 个处理阶段决定「由谁来处理、是否放行」,内容处理器(Handler)负责生成响应,过滤器链(Filter)负责加工响应。所有功能都是模块在这些环节上注册的回调,配置文件的本质就是「告诉每个模块在哪个作用域做什么」。
一、模块体系:一切皆模块 Nginx 的核心代码只提供最基础的框架,所有具体能力都由模块实现。模块按层次可以分为五类:
ngx_core_module ngx_events_module ngx_http_core_module ngx_stream_proxy_module ngx_mail_smtp_module
每个模块都用一个 ngx_module_t 结构体描述,其中最重要的是两部分:
• **指令表(commands):**声明模块支持哪些配置指令、允许出现在哪些上下文,以及解析时调用哪个函数。 • **上下文(ctx):* 对 HTTP 模块来说,就是 create_main_conf 、 create_srv_conf 、 create_loc_conf 和对应的 merge_ 函数,决定了配置如何在各层之间继承。 模块可以静态编译进二进制,也可以编译成动态模块(.so),用 load_module 按需加载。注意:动态模块必须和 Nginx 主程序用相同的版本和编译参数构建,否则会因为二进制不兼容而拒绝加载。
二、配置的继承与合并 HTTP 配置是一棵层层嵌套的树:http → server → location(location 还可以继续嵌套)。每一层的每个模块都有一份自己的配置结构体。解析完成后,框架自顶向下调用 merge_* 函数:内层没有设置的值,就继承外层的值。
但是有一类指令是例外:数组型指令,比如 add_header 、 proxy_set_header ,遵循「要么全部继承,要么完全不继承」的规则:
server { add_header X-Frame-Options DENY; location /api/ { add_header X-Request-Id $request_id ; # 结果:/api/ 下只有 X-Request-Id,X-Frame-Options 丢失了! } } 只要内层写了一条 add_header ,外层所有的 add_header 就都不再生效。这是线上最常见的配置陷阱之一。从 1.29.3 开始(1.30 stable 已包含),可以用 add_header_inherit merge; 改为「追加合并」:
http {
    add_header_inherit merge; # 在顶层声明一次,递归作用于所有下层
}
三、请求解析与 server 选择 1. **读取与解析:**Worker 从连接上读取数据,用手写的状态机逐字节解析请求行和请求头,速度很快,而且不依赖正则表达式。请求头先放在 client_header_buffer_size (默认 1k)大小的缓冲区里;超出后,再从 large_client_header_buffers (默认 4 个 8k)中分配。单个请求头超出一个大缓冲区时返回 400;请求行超出时返回 414。 2. 选择 server:先按 listen 的 IP(Internet Protocol,网际协议)地址和端口圈出候选的 server 块,再用 Host 头(HTTPS 时优先用 SNI)按以下顺序匹配 server_name : 3. 精确名称,如 www.example.com 4. 以通配符开头的最长名称,如 *.example.com 5. 以通配符结尾的最长名称,如 www.example.* 6. 按配置顺序匹配正则表达式,如 ~^api\d+\.example\.com$ 7. 都没有匹配时,使用该监听地址上的 default_server ;没有显式指定 default_server 的话,就用第一个 server 块 四、11 个处理阶段 请求头解析完成后,就进入阶段引擎。Nginx 在启动时把各模块注册的回调扁平化为一个数组,每个元素带一个 checker 函数,由它决定下一步是执行下一个回调、跳到某个阶段,还是结束请求。 ngx_http_core_run_phases () 只需要沿着这个数组往下走。
POST_READ SERVER_REWRITE server 块中的 rewrite、set、return FIND_CONFIG 根据 URI(Uniform Resource Identifier,统一资源标识符)匹配 location POST_REWRITE 被重写就跳回 FIND_CONFIG ,最多重复 10 次 limit_req allow / deny、 auth_basic 、 auth_request POST_ACCESS try_files proxy_pass 、 fastcgi_pass 、index、static access_log
💡 **理解执行顺序:**配置文件中指令的书写顺序不代表执行顺序,执行顺序由阶段决定。例如,无论 limit_req 写在 rewrite 前面还是后面,都一定是 rewrite 先执行。这也解释了为什么 return 会让同一 location 里的 allow / deny 失效:return 属于 REWRITE 阶段,在 ACCESS 阶段之前就结束了请求。
五、location 匹配规则 FIND_CONFIG 阶段按下面的优先级为请求选择 location:
1. 精确匹配 = :完全相等时立即选中,停止搜索。 2. **前缀匹配:**找出匹配的最长前缀并记下。如果它带有 ^~ 修饰符,就直接选中,停止搜索。 3. 正则匹配 ~(区分大小写)/ ~*(不区分大小写):按配置文件中出现的顺序逐个检查,第一个匹配的就被选中。 4. 谓词匹配 $变量 (1.31.5+,mainline):正则都没有匹配时,按顺序检查谓词 location,变量值非空且不为 "0" 就算匹配。 5. 以上都不匹配时,使用第 2 步记下的最长前缀 location。 示例:
location ~* .(png|jpg)$ {}
⚠️ 注意:/images/a.png 即使另外配置了 location /images/ {},也会被正则 location 抢走,因为普通前缀匹配只是「记下」,正则仍然会参与匹配。如果想让前缀优先,请使用 ^~。
谓词 location:按请求内容路由(mainline 新特性)。过去 location 只能按 URI 匹配,按请求头或请求体路由只能借助 if 或脚本。1.31.5 起,任何变量都可以作为 location 的匹配条件,并且可以配合 client_body_early_read 和 ngx_http_json_module ,在选择 location 之前就解析 JSON(JavaScript Object Notation,JavaScript 对象表示法)格式的请求体:
client_body_early_read on ; # 在 location 匹配之前读取请求体 json_set $vip $request_body user.params.vip; # 从 JSON 中提取字段作为变量 server { location $vip { proxy_pass http://vip_backend; } # vip 字段为真值时命中 location / { proxy_pass http://normal_backend; } } 六、内容处理器与过滤器链 内容处理器(Handler):每个请求最终只能由一个 Handler 生成响应。如果 location 中配置了 proxy_pass 、 fastcgi_pass 、 grpc_pass 等指令,对应模块就会把自己设置为这个 location 的专属 Handler;否则,就按顺序尝试 CONTENT 阶段注册的通用 Handler:index、 autoindex 、static(静态文件)。
过滤器链(Filter):Handler 生成的响应还要经过一串过滤器加工,分为两条链:
• header filter 链:处理响应状态行和响应头,例如 not_modified (处理 304)、headers( add_header 、expires)、 gzip (修改 Content-Encoding)。 • body filter 链:处理响应体,例如 sub(文本替换)、 gzip (压缩)、chunked(分块编码),最后由 write filter 真正写入 Socket。 过滤器链是一个单向链表:每个 filter 模块初始化时,都把自己插到链表头部,并保存原来的链表头作为「下一个」。因此执行顺序和注册顺序相反,这个顺序在编译时由 configure 生成的模块列表决定。
💡 **流式处理:**body filter 处理的是缓冲链( ngx_chain_t )而不是完整的响应体。后端返回一块数据,就立即流经整条过滤链并发出去,不需要等待完整的响应,所以内存占用与响应大小无关(详见 05 篇)。
七、变量:配置的表达能力 $host 、 $remote_addr 、 $upstream_status 等变量是 Nginx 配置灵活性的来源,它的实现有两个关键特征:
• **惰性求值:**变量只在真正被使用时才计算。例如, $request_body 只有被引用时才会读取请求体。 • **索引化缓存:**配置解析阶段,每个被引用的变量都会分配一个索引。请求中第一次求值后,结果缓存在 r->variables[index] 中,后续访问直接读取缓存。 map 是构造变量的主要工具,同样是惰性求值的:
map $http_user_agent $is_mobile { default 0 ; ~*(android|iphone) 1; } 八、内部跳转与子请求 内部跳转(Internal Redirect):rewrite ... last、 try_files 的最后一个参数、 error_page ,都会让请求带着新 URI 回到 FIND_CONFIG 阶段重新匹配 location。这个过程不会产生新的 TCP 连接,客户端也感知不到。为了防止死循环,最多允许跳转 10 次,超过后返回 500。
子请求(Subrequest):在一个主请求内部,再发起一个或多个请求,并复用同一个连接。典型用法有:
• auth_request :先向鉴权服务发送子请求,根据它返回的 2xx 或 401 / 403 决定是否放行主请求。 • **mirror:**把请求复制一份发往测试环境,用于流量回放,镜像请求的响应会被丢弃。 • SSI(Server Side Includes,服务端包含):把多个子请求的响应拼接成一个页面。多个子请求的输出由 postpone filter 保证按正确的顺序输出。 04 反向代理与负载均衡:upstream 原理 核心结论:反向代理就是 Worker 替客户端向后端发起一个非阻塞的请求,再把响应流式转发回去。决定其表现的是三件事:选谁(负载均衡算法)、怎么连(连接复用与超时)、出错怎么办(被动健康检查与重试)。从 1.29.7 起(1.30 stable 已包含),Nginx 默认启用到后端的 HTTP/1.1 长连接,这是近年对代理行为影响最大的一次变化。
一、一次代理请求的完整流程 proxy、 fastcgi 、 grpc 、uwsgi 等模块都建立在同一个 upstream 框架( ngx_http_upstream_t )之上。各协议模块只需要实现「如何构造请求」「如何解析响应头」等几个回调,连接管理、超时、重试、缓冲都由框架统一处理。
1. **读取请求体:**默认( proxy_request_buffering on)先把客户端请求体完整读完,放在内存或临时文件里,再开始连接后端。这样可以避免慢速客户端长时间占用后端。 2. **选择后端:**调用负载均衡模块的 get 回调选出一个节点(见第三节)。 3. **建立连接:**优先从 keepalive 连接池里取一个空闲连接;没有空闲连接,才发起非阻塞的 connect(),同时启动 proxy_connect_timeout 定时器。 4. **发送请求:**写入请求行、请求头(按 proxy_set_header 改写)和请求体,受 proxy_send_timeout 约束。 5. **读取响应头:**等待后端响应,受 proxy_read_timeout 约束。解析状态行和响应头,交给 header filter 链处理。 6. **转发响应体:**按缓冲模式把后端数据转发给客户端(见第二节)。 7. **收尾:* 释放后端连接:如果可以复用,就放回 keepalive 池,否则关闭。记录 $upstream_ 系列变量,供日志使用。 二、缓冲:Nginx 如何隔离快慢两端 客户端通常是「慢」的(移动网络、跨地域),后端通常是「快」而「贵」的(每个连接都占用应用线程)。缓冲的目的是让后端尽快处理完、尽快释放连接,由 Nginx 慢慢把数据喂给客户端。
proxy_request_buffering proxy_buffering 用 proxy_buffers 在内存中缓冲后端响应;装不下就写入临时文件(上限 proxy_max_temp_file_size ) 收到多少就同步转发多少,只使用一个 proxy_buffer_size 大小的缓冲区;适合流式接口(SSE(Server-Sent Events,服务器推送事件)、长轮询)
开启响应缓冲时,Nginx 用一个叫 event pipe( ngx_event_pipe_t )的组件同时处理「从后端读」和「向客户端写」两个方向的事件:两端各自独立推进,由缓冲区在中间调节速度差。
⚠️ 注意: proxy_buffer_size 同时决定了能接收的响应头最大值。后端返回很大的 Cookie 或头部时,会出现 upstream sent too big header,并返回 502。遇到这种情况,要调大的是 proxy_buffer_size ,而不是 proxy_buffers 。
三、负载均衡算法
least_conn ketama 算法:每个节点按权重在哈希环上放置 160 个虚拟点 需要会话粘滞或缓存亲和,节点增减时只影响少量 key ip_hash 对 IPv4 地址的前三段(或 IPv6 完整地址)做哈希 多个 Nginx 实例共同代理同一组后端,各自的连接计数都不完整时 least_time 综合平均响应时间和活跃连接数选择节点;1.31.0 起进入开源版 sticky 用 Cookie 或路由变量把同一客户端固定到同一节点;1.29.6 起进入开源版
平滑加权轮询(Smooth Weighted Round-Robin)是默认算法,它解决的问题是:权重 5:1:1 的三个节点 a、b、c,朴素的做法会连续发 5 个请求给 a,造成瞬时压力集中。Nginx 的算法如下:
1. 每轮选择时,每个节点的 current_weight 加上它自己的权重。 2. 选出 current_weight 最大的节点。 3. 被选中的节点, current_weight 减去所有节点的权重总和。
选择前 current_weight (a, b, c)
7 次选择得到的序列是 a a b a c a a:比例严格等于 5:1:1,而且 b、c 被均匀地穿插进去了。7 轮之后所有值都回到 0,开始新的周期。
💡 多 Worker 的影响:默认情况下,每个 Worker 各自维护一份轮询状态和失败计数。配置了 zone backend 64k; 后,这些状态才会放到共享内存里,由所有 Worker 共享。建议所有 upstream 都配置 zone。
四、被动健康检查与失败重试 开源版 Nginx 通过真实请求的失败来判断节点是否健康,称为被动健康检查:
• **判定:**在 fail_timeout (默认 10s)时间窗内,失败次数达到 max_fails (默认 1),这个节点就被标记为不可用,时长同样是 fail_timeout 。 • **恢复:**不可用时间结束后,放行一个请求去试探。成功就恢复正常,失败就继续标记为不可用。 • **什么算失败:**连接或读写出错(error)、超时(timeout)、响应头不合法( invalid_header )总是计为失败; http_500 、 http_502 、 http_503 、 http_504 、 http_429 只有在 proxy_next_upstream 中显式列出,才计为失败;403 和 404 永远不计为失败。 失败重试(next upstream ):当前节点失败时,只要还没有向客户端发送任何数据,就会换一个节点重试:
proxy_next_upstream error timeout http_502 http_503; proxy_next_upstream_tries 2 ; # 最多尝试 2 个节点(含第一次) proxy_next_upstream_timeout 5s ; # 重试的总时间上限 ⚠️ 幂等性保护:从 1.9.13 起,POST、LOCK、PATCH 等非幂等请求默认不会被重试,以免重复下单这类问题;除非显式加上 non_idempotent 参数。所有节点都不可用时,error.log 会记录 no live upstreams,并返回 502。 主动健康检查( health_check ,定期主动探测后端)属于商业版功能,开源版一般通过外部探测配合服务发现来实现。
五、到后端的连接复用:keepalive 为什么重要:如果每个请求都新建一个到后端的 TCP 连接,除了握手带来的延迟,Nginx 这一侧还会积累大量 TIME_WAIT 状态的连接,最终耗尽本地端口,出现 Cannot assign requested address。
1.29.7 带来的默认值变化(1.30 stable 已包含):
upstream keepalive proxy_http_version 默认发送 close,必须用 proxy_set_header Connection "" 清空
其中 local 参数表示:缓存的连接只在同一个 location 内复用,不跨 location 共享,避免不同 location 设置的请求头在同一条连接上互相干扰。32 是每个 Worker 为每个 upstream 最多保留的空闲连接数,不是连接总数的上限。
相关参数:
upstream backend { zone backend 64k ; server 10.0.0.1:8080 ; server 10.0.0.2:8080 ; keepalive 64 ; # 每个 Worker 最多保留的空闲连接数 keepalive_timeout 50s ; # 空闲连接的保留时长(默认 60s) keepalive_requests 1000 ; # 单个连接最多承载的请求数 } ⚠️ 升级注意:从旧版本升级到 1.30 后,原本「每个请求一个短连接」的服务会自动变成长连接。如果后端的空闲超时比 Nginx 的 keepalive_timeout 还短,后端会先关闭连接,而 Nginx 恰好在这时复用了这条连接,就会出现偶发的 upstream prematurely closed connection 和 502。原则:Nginx 的 keepalive_timeout 要小于后端的空闲超时。详见 08 篇案例一。
六、服务发现:后端地址会变怎么办 server backend.svc:8080; 这种写法中的域名,只在启动或 reload 时解析一次。后端 IP 变化后,Nginx 仍然会连接旧的地址。有两种解决办法:
• resolve 参数(开源版从 1.27.3 起支持): upstream 需要配置 zone,同时配置 resolver ,Nginx 会按 DNS 的 TTL(Time To Live,生存时间)周期性地重新解析,自动增删节点。 • 在 proxy_pass 中使用变量: proxy_pass http://$backend_host; 每次请求都会通过 resolver 异步解析,但这种方式无法使用 upstream 的负载均衡和 keepalive 能力。 resolver 10.0.0.2 valid= 10s ; upstream backend { zone backend 64k ; server backend.default.svc.cluster.local: 8080 resolve; } 七、后端协议:HTTP/2、gRPC 与更多 • HTTP/2 后端(1.29.4+): proxy_http_version 2; 可以让 proxy 模块用 HTTP/2 连接后端,在一条连接上多路复用多个请求。 • gRPC(Google Remote Procedure Call,谷歌远程过程调用框架): grpc_pass grpc ://backend;,基于 HTTP/2,支持流式调用。 • FastCGI / uWSGI / SCGI:分别用于对接 PHP-FPM(FastCGI Process Manager,FastCGI 进程管理器)和 Python 等应用服务器。 • CONNECT 隧道(1.31.0+,mainline): ngx_http_tunnel_module 处理 HTTP CONNECT 请求,可以让 Nginx 充当正向代理。 八、四层代理:stream 模块 stream 模块用和 HTTP 相同的事件模型和 upstream 框架代理 TCP / UDP 流量,只是没有 HTTP 解析,处理阶段也更简单:Post-accept → Pre-access → Access → SSL → Preread → Content → Log。
• ssl_preread :只读取 TLS 握手中的 SNI,不解密流量,就能按域名把连接分发到不同后端,可以实现「TLS 透传」。 • proxy_protocol :在转发时附带客户端的真实地址,1.31.4 起在 stream 和 mail 模块中支持 PROXY protocol v2 版本。 • 支持的负载均衡算法、 max_fails 被动健康检查、resolve 动态解析,都与 HTTP upstream 一致。 05 内存、缓冲与缓存:内存池、零拷贝与 proxy_cache 核心结论:Nginx 的高效,一半来自事件模型,另一半来自「少分配、少拷贝、少读盘」:内存池让内存按生命周期批量释放;缓冲链让数据在各模块之间传递时只传指针; sendfile 让文件数据不经过用户态; proxy_cache 让重复的请求不再访问后端。
一、内存池:按生命周期管理内存 C 语言服务器最常见的两类问题是内存泄漏和内存碎片。Nginx 的对策是 ngx_pool_t 内存池:只分配、不单独释放,生命周期结束时整体销毁。
内存池的结构:
• **小块内存:**从池中预先申请的内存块里,通过移动指针的方式分配,速度接近栈分配。当前内存块不够用时,再申请一个新块,用链表串起来。 • **大块内存:**超过阈值(接近一个内存页大小)的申请,直接调用 malloc 分配,挂在 large 链表上,可以单独释放。 • **清理回调(cleanup):**需要在销毁时执行的动作(例如关闭文件、释放锁)以回调的形式注册,池销毁时统一执行。 三种典型的生命周期:
接受连接时( connection_pool_size )
这种设计让模块开发者不必关心 free:只要从正确的池里分配,内存就一定会在正确的时间被回收。
二、缓冲与缓冲链:传指针,不传数据 Nginx 在各模块之间传递数据时,统一使用两个结构:
• ngx_buf_t (缓冲区):描述「一段数据在哪里」。它既可以指向内存(pos 到 last),也可以指向文件的某个区间( file_pos 到 file_last )。标志位 last_buf 表示响应结束,flush 表示需要立即发送。 • ngx_chain_t (缓冲链):把多个 ngx_buf_t 串成链表。 过滤器处理数据时,传递的是缓冲链,不是数据本身。例如,给响应追加内容时,只需要在链表中插入一个新节点;如果缓冲区指向的是文件,数据从头到尾都不会被读进用户态内存,最终直接交给 sendfile 发送。
缓冲区复用: upstream 等模块会维护 free(空闲)和 busy(数据还在发送中)两条链。一块缓冲区的数据被内核完全接收后,它就从 busy 链移回 free 链,接着装下一批数据。所以即使转发 1 GB 的响应,内存占用也始终只有配置的若干个缓冲区大小。
三、零拷贝:sendfile 发送一个静态文件时,传统方式与 sendfile 的对比如下:
4 次:磁盘 → 页缓存 → 用户缓冲区 → Socket 缓冲区 → 网卡 sendfile 2 次 DMA(Direct Memory Access,直接内存访问)拷贝,外加最多 1 次内核内拷贝,数据不经过用户态
相关指令的配合:
sendfile on ; # 开启零拷贝发送 sendfile_max_chunk 2m ; # 单次 sendfile 的上限,防止一个大文件独占 Worker(1.21.4 起默认 2m) tcp_nopush on ; # 开启 TCP_CORK:先把响应头和文件开头拼成满包再发送 tcp_nodelay on ; # keepalive 连接上关闭 Nagle 算法,小包立即发送 ⚠️ sendfile 不适用的场景:启用了 gzip 压缩或 SSI 这类需要修改响应体的过滤器、启用了 TLS(数据需要在用户态加密)时,数据必须读进内存处理, sendfile 自动失效。Linux 内核的 kTLS(Kernel TLS,内核态 TLS)可以缓解这个问题,Nginx 通过 ssl_conf_command Options KTLS; 启用,需要 OpenSSL 3.0+ 和内核的支持。
大文件的另一条路径:页缓存命中率低的超大文件(例如视频),可以用 directio 4m; 绕过页缓存,再配合 aio threads; 用线程池异步读取,避免 Worker 阻塞在磁盘 I/O 上。
四、共享内存与 slab 分配器 多个 Worker 需要共享的数据,比如限流计数、SSL 会话、缓存索引、 upstream 状态,都存放在共享内存 zone 中。
• **创建:**Master 在 fork 之前用 mmap 创建匿名共享内存,Worker 继承后就能直接访问同一块物理内存。 • **分配:**zone 内部用 slab 分配器管理:先按内存页划分,再按 2 的幂次划分为不同规格的槽位(8 字节、16 字节、32 字节……)。同规格的对象放在一起,避免产生碎片。 • **同步:**每个 zone 有一把互斥锁( ngx_shmtx_t ),优先用原子操作加自旋实现;自旋一段时间仍拿不到锁,再退化为信号量等待。 • reload 时复用:名称、大小都没变的 zone 会被新一代配置直接复用,其中的数据不会丢失。 ⚠️ 容量规划:zone 装满后,新的条目会分配失败。例如 limit_req_zone 满了之后,会淘汰最久未使用的条目;实在淘汰不出空间,就会拒绝请求并返回 503,同时 error.log 中出现 could not allocate node。官方给出的参考容量:1 MB 的 ssl_session_cache 约能存放 4000 个会话;1 MB 的缓存 keys_zone 约能存放 8000 个 key。
五、proxy_cache:把后端响应缓存在本地 配置示例:
proxy_cache_path /data/cache levels= 1 : 2 keys_zone=api_cache: 100m max_size= 50g inactive= 7d use_temp_path= off ; server { location /api/ { proxy_cache api_cache; proxy_cache_key host $request_uri ; proxy_cache_valid 200 302 10m ; proxy_cache_lock on ; # 防止缓存击穿 proxy_cache_use_stale error timeout updating; # 后端故障时返回旧缓存 proxy_cache_background_update on ; # 在后台刷新过期缓存 add_header X-Cache-Status $upstream_cache_status ; proxy_pass http://backend; } } 存储结构:两级存储。
• 内存( keys_zone ):存放索引,用红黑树按 key 的 MD5(Message-Digest Algorithm 5,消息摘要算法第 5 版)值查找,同时维护一个 LRU(Least Recently Used,最近最少使用)队列,用于淘汰。 • **磁盘:**存放完整的响应(响应头 + 响应体),文件名就是 MD5 值,levels=1:2 表示按 MD5 值的末尾字符建立两级子目录,避免单个目录下的文件过多。 一次请求的处理流程:
1. 按 proxy_cache_key 计算 MD5,在共享内存中查找索引。 2. **命中且未过期(HIT):**直接读取磁盘文件返回(通常命中页缓存,并且可以使用 sendfile ),完全不访问后端。 3. 未命中(MISS)或已过期(EXPIRED):向后端请求。响应一边返回给客户端,一边写入临时文件,完成后原子地 rename 为正式的缓存文件。 4. **缓存击穿保护:**开启 proxy_cache_lock 后,同一个 key 同时只有一个请求访问后端,其他请求等待它写完缓存后,直接读缓存。 5. **过期处理:**开启 proxy_cache_use_stale updating 和 background_update 后,过期内容先返回旧版本(UPDATING / STALE),同时在后台发起子请求刷新缓存,用户感受不到延迟。 $upstream_cache_status 的常见取值有:HIT、MISS、EXPIRED、STALE、UPDATING、REVALIDATED、BYPASS。在日志中记录这个变量,是分析缓存命中率最直接的办法。
缓存有效期由谁决定:后端返回的 Cache-Control、Expires 响应头优先;没有这些头时,才使用 proxy_cache_valid 。后端返回 Set-Cookie 或 Cache-Control: private 的响应默认不会被缓存,这一点经常导致「缓存配了却不生效」。
六、open_file_cache:缓存文件元数据 静态文件服务器每处理一个请求,都要执行 open()、fstat() 等系统调用。 open_file_cache 在 Worker 本地缓存文件描述符、文件大小、修改时间,以及「文件不存在」这类查找结果:
open_file_cache max= 10000 inactive= 60s ; open_file_cache_valid 30s ; # 每 30 秒重新校验一次缓存项 open_file_cache_errors on ; # 同时缓存「文件不存在」等错误结果 💡 **代价:**文件更新后,最多要等 open_file_cache_valid 这么长的时间才会生效。发布频繁的静态站点,要结合发布方式(例如带版本号的文件名)来权衡。
06 协议栈:TLS、HTTP/2 与 HTTP/3(QUIC) 核心结论:三种协议在 Nginx 中都是事件驱动的状态机,握手或读写无法立即完成时就让出 Worker,与普通请求一样不会阻塞。它们解决的问题层层递进:TLS 解决安全问题;HTTP/2 在一条 TCP 连接上多路复用,解决 HTTP 层的队头阻塞;HTTP/3 把传输层换成基于 UDP 的 QUIC,进一步消除 TCP 层的队头阻塞,并支持连接迁移。
一、三代 HTTP 协议对比
每个连接同时只能处理一个请求,浏览器靠开多个连接实现并发 同 HTTP/2,而且流与流之间在传输层也相互独立 解决了 HTTP 层;TCP 丢一个包,所有流都要等待重传 TCP 握手 + TLS 握手,约 2~3 RTT(Round-Trip Time,往返时延) 支持:手机从 Wi-Fi 切到 4G 后,连接不中断
二、TLS:安全与性能的平衡 1. 非阻塞握手 TLS 握手需要多次往返。Nginx 调用 OpenSSL 的 SSL_do_handshake (),如果返回 SSL_ERROR_WANT_READ 或 SSL_ERROR_WANT_WRITE ,就把连接的 handler 设置为「继续握手」,然后返回事件循环;数据到达后再接着握手。握手完成后,读写操作通过 SSL_read () 和 SSL_write () 进行,处理方式相同。
2. 握手的 CPU 开销与优化 完整握手中最耗 CPU 的是证书私钥签名运算。常见的优化手段:
ssl_session_cache 会话信息存放在共享内存中,所有 Worker 都能复用;1 MB 约可存放 4000 个会话 ssl_session_tickets 同时配置 RSA(Rivest–Shamir–Adleman,一种公钥算法)和 ECDSA 两套证书 ECDSA(Elliptic Curve Digital Signature Algorithm,椭圆曲线数字签名算法)签名比 RSA 快得多;老客户端自动回退到 RSA ssl_protocols ssl_early_data ssl_certificate_cache 、 ssl_object_cache_inheritable (1.27.4+) reload 时复用已经加载的证书,减少大量证书场景下的 reload 耗时
⚠️ 两个安全细节:
3. 近期 TLS 相关演进 • **证书压缩(1.29.1):**TLS 1.3 的证书压缩改为默认关闭,可以用 ssl_certificate_compression on; 显式开启。 • ECH(Encrypted ClientHello,加密客户端问候,1.29.4):加密握手中的 SNI,防止网络中间设备看到访问的域名。需要使用 OpenSSL 的 ECH 特性分支构建,用 ssl_ech_file 配置。 • **加密库:**除了 OpenSSL,也支持 BoringSSL、LibreSSL;1.29.2 起支持 AWS-LC(Amazon Web Services libcrypto,亚马逊维护的加密库),1.29.8 起兼容 OpenSSL 4.0。1.29.0 起可以通过 OpenSSL provider 从硬件令牌加载私钥。 • **证书自动化:**官方提供 ngx_http_acme_module 动态模块,通过 ACME(Automatic Certificate Management Environment,自动证书管理环境)协议自动申请和续期证书,不再需要依赖外部的 certbot 脚本。 • OCSP 装订: ssl_stapling on; 由服务端代替客户端查询 OCSP(Online Certificate Status Protocol,在线证书状态协议)状态。注意,部分 CA(Certificate Authority,证书颁发机构)已经停止提供 OCSP 服务,例如 Let's Encrypt,对这类证书开启装订没有意义。 三、HTTP/2:一个连接,多个请求 1. 开启 HTTP/2 从 1.25.1 起,使用独立的 http2 指令开启,原来的 listen ... http2 写法已被废弃:
server { listen 443 ssl; http2 on ; } 同一版本还移除了 Server Push。主流浏览器已经放弃这个特性,替代方案是 103 Early Hints:1.29.0 起, early_hints 指令可以把后端返回的 103 响应转发给客户端,让浏览器提前加载关键资源。
2. HTTP/2 在 Nginx 中的实现 • **连接与流:**一条 TCP 连接对应一个 ngx_http_v2_connection_t 。每个流(Stream)创建一个独立的 ngx_http_request_t ,同时配一个「伪连接」,所以流在进入 11 个阶段之后,处理方式和 HTTP/1.1 请求完全一样,上层模块不需要感知 HTTP/2。 • **帧解析:**用状态机逐帧解析 HEADERS、DATA、SETTINGS、 WINDOW_UPDATE 等帧;请求头经过 HPACK 解码后,还原成普通的请求头结构。 • **输出:**各个流产生的数据封装成帧,放入连接级别的发送队列,发送时同时受流级和连接级两层流控窗口约束。 3. 关键限制参数
http2_max_concurrent_streams keepalive_requests 单个连接上允许的最大请求数,同样适用于 HTTP/2 http2_recv_buffer_size 每个 Worker 的 HTTP/2 读缓冲区大小 large_client_header_buffers
💡 **安全意义:**这些限制是抵御 HTTP/2 协议层攻击的第一道防线,例如 2023 年的 Rapid Reset(CVE-2023-44487,CVE 即 Common Vulnerabilities and Exposures,通用漏洞披露编号)攻击,攻击者就是通过大量快速创建并取消流来耗尽服务端资源。不建议随意把这些参数调大。
四、HTTP/3 与 QUIC:把传输层搬到用户态 1. 开启 HTTP/3 server { listen 443 ssl; # TCP:HTTP/1.1 和 HTTP/2 listen 443 quic reuseport; # UDP:HTTP/3 http2 on ; http3 on ; quic_retry on ; # 验证客户端地址,抵御伪造源地址的攻击 add_header Alt-Svc 'h3=":443"; ma=86400' ; # 告诉浏览器这个站点支持 HTTP/3 } 浏览器第一次通常用 TCP 访问,看到 Alt-Svc 响应头后,下一次才会尝试 HTTP/3。所以 TCP 监听必须保留,UDP 443 端口也要在防火墙和安全组上放行。
2. QUIC 在 Nginx 中的实现 QUIC 本身包含了可靠传输、拥塞控制、流量控制和 TLS 1.3 加密,这些在 TCP 中是由内核实现的,在 Nginx 中全部由 Worker 在用户态实现( ngx_event_quic 模块):
• **收包:**Worker 从 UDP Socket 读取数据报,根据包头中的连接 ID(Connection ID)找到对应的 QUIC 连接,而不是依赖 IP 地址和端口组成的四元组。 • **加解密:**每个包单独加密,使用 TLS 1.3 协商出的密钥。0-RTT 需要 OpenSSL 3.5.1 及以上版本(1.29.1 起支持),也可以使用 BoringSSL、QuicTLS 等库。 • **可靠性:**Worker 自己维护确认(ACK)、丢包检测、重传和拥塞控制(1.27.5 起支持 CUBIC 算法)。 • **流:**每个 HTTP/3 请求对应一个 QUIC 流,头部使用 QPACK 压缩,之后与 HTTP/2 一样创建 ngx_http_request_t ,进入 11 个阶段处理。 3. 关键难点:数据包必须送到正确的 Worker TCP 连接一旦建立,就固定属于 accept 它的那个 Worker。UDP 没有连接的概念,reuseport 按四元组哈希把数据包分给 Worker。问题在于,客户端的 IP 或端口一旦变化,例如 NAT(Network Address Translation,网络地址转换)重新绑定或者网络切换,数据包就可能被分到另一个 Worker,而那个 Worker 上并没有这条连接的状态。
Nginx 的解决方案是 quic_bpf on;(仅 Linux):在内核中加载一段 eBPF(extended Berkeley Packet Filter,扩展伯克利包过滤器)程序,按连接 ID 把数据包路由到正确的 Worker,从而真正支持连接迁移。
⚠️ 生产建议:HTTP/3 的实现仍在快速演进,近两年的版本中频繁修复与 QUIC 相关的安全问题,例如 1.31.0、1.31.2、1.31.6 都包含 HTTP/3 的 CVE 修复。启用 HTTP/3 时,务必跟进最新的 stable 版本,并且使用较新的 OpenSSL(3.5.1+)。
07 使用实践:配置组织、典型场景与性能调优 核心结论:用好 Nginx 的关键不在于记住多少指令,而在于三件事:配置可维护(分层组织、变更前校验)、场景有模板(静态资源、API 代理、WebSocket、限流、HTTPS 各有一套经过验证的写法)、调优有依据(先看指标和日志定位瓶颈,再改参数)。
一、配置的组织方式 推荐的目录结构:
/etc/nginx/
├── nginx.conf # 全局配置:进程、events、http 公共参数
├── conf.d/
│   ├── upstreams.conf # 所有 upstream 定义
│   └── maps.conf # 公共 map,例如 WebSocket 升级头
├── sites/
│   ├── api.example.com.conf
│   └── www.example.com.conf
└── snippets/
    ├── ssl-common.conf # TLS 公共参数
    └── proxy-common.conf # proxy_set_header、超时等公共参数
变更的基本规范:
1. 先校验,再生效: nginx -t 检查语法和文件引用,通过后再执行 reload。在 1.31.5+ 上,可以直接用 Control API 发起 reload,然后根据返回的状态码判断是否成功。 2. 查看最终生效的配置: nginx -T 会输出展开所有 include 之后的完整配置,排查「到底哪条配置生效了」时非常有用。 3. **配置纳入版本管理:**配置文件放进代码仓库,通过 MR(Merge Request,合并请求)评审后再发布,并保留回滚能力。 二、典型场景配置模板 场景 1:前端静态资源 + 单页应用 server { listen 443 ssl; http2 on ; server_name www.example.com; root /var/www/app/dist; location / { try_files $uri $uri / /index.html; # 前端路由统一回落到 index.html } location ~* .(js|css|png|jpg|svg|woff2)$ { expires 30d ; # 带哈希文件名的资源可以长期缓存 add_header Cache-Control "public, immutable" ; } location = /index.html { add_header Cache-Control "no-cache" ; # 入口文件不缓存,保证发布后立即生效 } } 场景 2:API 反向代理 upstream api_backend { zone api_backend 64k ; least_conn; server 10.0.1.11:8080 max_fails= 3 fail_timeout= 10s ; server 10.0.1.12:8080 max_fails= 3 fail_timeout= 10s ; keepalive 64 ; keepalive_timeout 50s ; # 小于后端的空闲超时 } server { listen 443 ssl; server_name api.example.com; client_max_body_size 10m ; location /api/ { proxy_pass http://api_backend; proxy_set_header Host $host ; proxy_set_header X-Real-IP $remote_addr ; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for ; proxy_set_header X-Forwarded-Proto $scheme ; proxy_connect_timeout 3s ; proxy_read_timeout 30s ; proxy_next_upstream error timeout; proxy_next_upstream_tries 2 ; } } ⚠️ proxy_pass 结尾的斜杠: proxy_pass http://api_backend; 会把原始 URI 原样转发给后端; proxy_pass http://api_backend/; 则会把匹配到的 location 前缀替换成 /,例如 /api/users 会变成 /users。这是最常见的「404 找不到接口」原因之一。
场景 3:WebSocket map $http_upgrade $connection_upgrade { default upgrade; '' close; } location /ws/ { proxy_pass http://ws_backend; proxy_set_header Upgrade $http_upgrade ; proxy_set_header Connection $connection_upgrade ; proxy_read_timeout 1h ; # 长连接,放宽读超时;建议客户端定期发心跳 } 场景 4:限流 limit_req_zone $binary_remote_addr zone=per_ip: 20m rate=20r/s; limit_conn_zone $binary_remote_addr zone=conn_ip: 10m ; server { location /api/ { limit_req zone=per_ip burst= 40 nodelay; # 允许短时突发 40 个请求,超出的立即拒绝 limit_req_status 429 ; # 默认返回 503,改为语义更准确的 429 limit_conn conn_ip 50 ; proxy_pass http://api_backend; } } limit_req 基于漏桶算法:rate 是漏水的速度,burst 是桶的容量。加上 nodelay 后,桶内的请求立即处理,不排队等待,只占用桶的额度;不加 nodelay 的话,突发请求会被按 rate 匀速放行,造成额外的延迟。
💡 真实客户端 IP:Nginx 前面还有 SLB(Server Load Balancer,负载均衡器)或 CDN 时, $remote_addr 拿到的是它们的地址,限流会误伤所有用户。需要先用 realip 模块还原真实 IP: set_real_ip_from 10.0.0.0/8; real_ip_header X-Forwarded-For; real_ip_recursive on;。
场景 5:HTTPS 公共参数 ssl_protocols TLSv1. 2 TLSv1. 3 ; ssl_certificate /etc/nginx/certs/example.com.ecdsa.crt; ssl_certificate_key /etc/nginx/certs/example.com.ecdsa.key; ssl_certificate /etc/nginx/certs/example.com.rsa.crt; # 兼容老客户端 ssl_certificate_key /etc/nginx/certs/example.com.rsa.key; ssl_session_cache shared:SSL: 50m ; ssl_session_timeout 1d ; add_header Strict-Transport-Security "max-age=31536000" always; # HSTS 其中 HSTS 是 HTTP Strict Transport Security(HTTP 严格传输安全),它要求浏览器在有效期内只通过 HTTPS 访问这个站点。
三、性能调优清单
worker_processes worker_rlimit_nofile worker_connections sendfile / tcp_nopush / tcp_nodelay keepalive_timeout gzip_comp_level access_log open_file_cache net.core.somaxconn、net.ipv4. tcp_max_syn_backlog 需要配合 listen ... backlog=65535 net.ipv4. ip_local_port_range 否则会出现 Too many open files
✅ **调优原则:**每次只改一个参数,改之前记录基线,改完之后用压测或线上指标验证效果。多数性能问题的根因在后端或者配置错误,不在 Nginx 的参数本身。
四、常见配置陷阱
add_header 在内层重复声明,或者使用 add_header_inherit merge;(1.29.3+) add_header 4xx / 5xx 响应里没有 CORS(Cross-Origin Resource Sharing,跨域资源共享)头 alias 会用路径替换 location 前缀,root 则是把 URI 追加在路径后面 除 return、rewrite 外的指令行为难以预测(官方文档称之为「If is Evil」) if 里只放 return 和 rewrite ... last;其他需求改用 map 或谓词 location $host $host 始终有值且不带端口; $http_host 是原始请求头 没有配置 client_max_body_size
五、可观测性:日志与指标 1. **结构化访问日志:**访问日志是定位问题的第一手资料,建议统一使用 JSON 格式,并记录后端相关的时间字段: log_format json escape=json '{' '"time":" $remote_addr ","host":" $host ",' '"request":" $request ","status": $status ,"bytes": $body_bytes_sent ,' '"request_time": $request_time ,"upstream_addr":" $upstream_addr ",' '"upstream_status":" $upstream_status ",' '"upstream_connect_time":" $upstream_connect_time ",' '"upstream_header_time":" $upstream_header_time ",' '"upstream_response_time":" $upstream_response_time ",' '"request_id":" $request_id ","upstream_cache_status":" $upstream_cache_status "}' ; access_log /var/log/nginx/access.log json buffer= 64k flush= 5s ;
当前的客户端连接总数,等于 Reading + Writing + Waiting 累计接受的连接数和累计处理的连接数。两者不相等,说明连接池耗尽后有连接被丢弃 正在处理请求或发送响应的连接数,持续偏高通常意味着后端变慢
3. **链路追踪:**官方的 ngx_otel_module 支持 OpenTelemetry(开放遥测标准),可以把 Nginx 纳入全链路追踪体系。配合 $request_id 透传给后端,就能用同一个 ID 串起「网关 → 服务 → 数据库」的完整调用链。 08 线上故障诊断:方法论、错误速查与典型案例 核心结论:Nginx 的故障诊断遵循「先定界,再定位」:先根据状态码和日志中的时间字段,判断问题出在客户端 ↔ Nginx、Nginx 自身,还是 Nginx ↔ 后端这三段中的哪一段;再到对应的一段里用 error.log、系统指标和工具找到根因。绝大多数 5xx 问题的根因都在后端或者两端的超时配置不匹配,而不在 Nginx 本身。
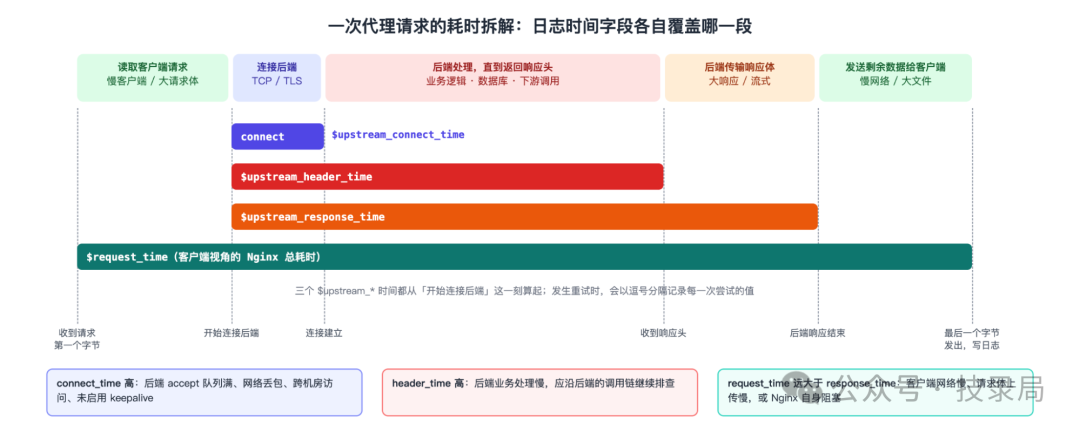
一、诊断方法论:四步定界法 1. **看现象:**是哪个状态码?是全部请求还是部分请求(某个域名、某个 location、某个后端节点)?是持续出现还是偶发?从什么时间开始?期间有没有发布或者配置变更? 2. **看时间:**用访问日志中的时间字段,判断时间花在了哪一段(见下图)。 3. **看错误:**在 error.log 中按时间和 request_id 找到对应的错误信息,错误信息通常会直接说明原因。 4. **看系统:**检查 CPU、内存、连接数、文件描述符、网络丢包和重传,确认是否存在资源瓶颈。
请求处理各阶段耗时分解示意图
💡 **前提条件:**以上分析依赖日志中记录了 $request_time 、 $upstream_connect_time 、 $upstream_header_time 、 $upstream_response_time 、 $upstream_addr 、 $upstream_status 。如果还没有记录这些字段,请先按照 07 篇第五节的模板补上。
二、状态码与错误日志速查
客户端在收到响应之前主动断开(Nginx 自定义状态码) client prematurely closed connection 客户端超时时间比后端处理时间短;用户主动取消;上一层代理超时 connect() failed (111: Connection refused) upstream prematurely closed connection 后端崩溃; keepalive 超时时间不匹配(案例一) upstream limiting requests, excess: ... 触发了 limit_req / limit_conn (默认状态码为 503) upstream timed out (110: Connection timed out) while reading response header 后端处理超过 proxy_read_timeout client intended to send too large body client sent too long URI 等 超过 large_client_header_buffers worker_connections accept4() failed (24: Too many open files) connect() ... (99: Cannot assign requested address) 本地端口耗尽,通常是因为没有使用 keepalive
⚠️ 注意日志中的「while ...」:error.log 的每条错误后面都带有 while connecting to upstream 、while reading response header from upstream 、while sending to client 等上下文,它直接说明了错误发生在哪一步,是定界最快的线索。
三、典型案例 案例一:升级到 1.30 后,偶发 502「upstream prematurely closed connection」 • **现象:**升级前一切正常,升级后出现低比例的 502,并且集中在流量低谷期。 • **分析:**1.29.7 起, upstream 默认启用 keepalive ,Nginx 会复用空闲连接。后端(例如 Node.js 的默认空闲超时是 5 秒)先于 Nginx(默认 60 秒)关闭了空闲连接,Nginx 恰好在这个时刻把请求写入了一条「后端刚刚关闭」的连接。流量低时,连接空闲的时间更长,所以低谷期更容易出现。 • **解决:**在 upstream 中设置 keepalive_timeout ,让它小于后端的空闲超时,例如后端是 5 秒,Nginx 就设为 4 秒;或者调大后端的空闲超时。对幂等请求, proxy_next_upstream error 默认会自动换一条连接重试,可以进一步掩盖这类偶发错误。 案例二:504 大量出现 • **现象:**某个接口大量返回 504, $upstream_header_time 接近 proxy_read_timeout 的值(例如 60 秒)。 • **分析:**时间消耗在「后端处理」这一段,Nginx 只是如实地等待,然后超时。应该沿着后端继续排查:线程池是否满了、数据库有没有慢查询、下游依赖是否超时。 • **解决:**先修复后端的问题。不要一上来就调大 proxy_read_timeout :超时时间越长,慢请求占用的连接越多,还可能引发雪崩。对确实需要长时间处理的接口,应该改成异步的方式,例如提交任务后轮询结果。 案例三:499 突然增多 • **现象:**499 的比例突然上升,同时 $request_time 普遍偏高。 • **分析:**499 是客户端「等不及」主动断开的结果,本质仍然是响应变慢,常见的情况有两种:一是后端变慢,但还没有慢到触发 Nginx 的超时;二是 Nginx 前面还有一层代理(SLB、网关、客户端 SDK(Software Development Kit,软件开发工具包)),它的超时时间比 Nginx 短。 • **解决:**按照请求链路对齐各层的超时,原则是越靠近客户端,超时越长。如果希望客户端断开后仍然让后端把请求处理完(例如支付回调),可以使用 proxy_ignore_client_abort on;。 案例四:reload 之后内存和进程数持续上涨 • **现象:**每次 reload 之后,ps 中都残留 worker process is shutting down,内存越来越高。 • **分析:**旧的 Worker 上还有 WebSocket、gRPC 流或者大文件下载这样的长连接,处理完之前不会退出;频繁 reload 就会不断叠加新旧两代 Worker。 • **解决:**配置 worker_shutdown_timeout 30s;,限制旧 Worker 的最长存活时间;降低 reload 的频率,例如通过 resolve 动态解析来代替「后端变化就 reload」;客户端需要实现断线重连。 案例五:某个 Worker 的 CPU 100%,整体延迟升高 • **现象:**top 中只有一两个 Worker 的 CPU 接近 100%,其他 Worker 比较空闲;延迟毛刺明显。 • **分析:**没有开启 reuseport 时,连接在 Worker 之间可能分配不均;或者某些请求触发了 CPU 密集型的操作(复杂正则、高级别 gzip 、大量 SSL 握手)。 • **定位:**用 perf top -p 查看热点函数:热点集中在 pcre 就是正则的问题,集中在 deflate 就是 gzip 的问题,集中在 RSA / EC 就是握手的问题。 • **解决:**开启 reuseport;优化正则并开启 pcre_jit ;调低压缩级别;提高 TLS 会话复用率。 案例六:连接数打满,新连接超时 • **现象:**客户端连接超时,error.log 出现 worker_connections are not enough,或者 Too many open files。 • **分析:**连接池或者文件描述符耗尽。常见原因有:后端变慢导致连接堆积;没有使用 keepalive 导致大量 TIME_WAIT ;ulimit 没有生效(例如 systemd 服务需要在 unit 文件中单独配置 LimitNOFILE)。 • **定位:**ss -s 查看各状态的连接数;ss -lnt 查看监听 Socket 的 Recv-Q,如果它持续接近 Send-Q,说明 accept 队列已满;nstat -az | grep -i listen 查看队列溢出的计数;cat /proc//limits 确认实际生效的文件描述符上限。 四、诊断工具箱
nginx -T nginx -T | grep -n proxy_read_timeout stub_status curl http://127.0.0.1/nginx_status curl --unix-socket ... /1/control/processes debug_connection events { debug_connection 10.0.0.5; },需要用 --with-debug 编译 ss -tanp state time-wait | wc -l strace -p -T -e trace=network,read,write curl -w '%{ time_connect } %{ time_starttransfer }\n' -o /dev/null -s URL
⚠️ 合规提示:在生产环境使用 tcpdump 抓包、strace / perf 跟踪进程,或者开启 debug 日志之前,应该按照公司流程申请授权,并评估这些操作对性能的影响(例如 strace 会显著拖慢被跟踪的进程)。抓包和日志中可能包含用户的敏感数据,不得外传。
五、预防:把故障挡在发生之前 • **监控告警:**对 5xx 比例、499 比例、 $upstream_response_time 的 P99(99 分位)、Active connections、accepts 与 handled 的差值设置告警。 • **变更规范:**所有配置变更都要经过 nginx -t 校验和评审;先灰度到一台机器上观察,再全量发布;每次发布都保留一键回滚的能力。 • 容量冗余: worker_connections 、文件描述符、共享内存 zone 的大小,都按峰值的 2 倍规划。 • **版本跟进:**关注官方的安全公告。近两年 HTTP/2、HTTP/3、rewrite 模块都出现过高危漏洞,stable 版本要及时升级。
阅读原文:原文链接



 400 186 1886